L’integrazione degli strumenti di intelligenza artificiale generativa nei flussi di lavoro quotidiani ha trasformato radicalmente la produttività, ma ha anche aperto falle critiche nella sicurezza, nella conformità normativa e nella qualità dei deliverable. Il rischio maggiore oggi non risiede nei limiti intrinseci della tecnologia, ma nelle modalità operative con cui professionisti e team aziendali vi fanno affidamento senza un quadro di regole preciso.
Utilizzare l’AI in ambito aziendale richiede di abbandonare l’approccio intuitivo tipico del contesto consumer. Dalla gestione dei dati sensibili alla validazione dei risultati, analizziamo i dieci errori più frequenti commessi nei contesti professionali e le strategie operative per neutralizzarli.
La superficie d’attacco più vulnerabile nell’uso dell’AI non è l’infrastruttura IT, ma la finestra di dialogo del modello. Molti utenti dimenticano che qualsiasi input testuale o file caricato può uscire dal perimetro di controllo dell’organizzazione.
Uno dei passi falsi più gravi consiste nell’incollare all’interno delle chat di strumenti pubblici (come le versioni base di ChatGPT, Claude o Gemini) estratti di bilanci non approvati, codice proprietario, cartelle cliniche, contratti in bozza o dati anagrafici dei clienti (PII).
Nelle configurazioni consumer standard, i dati forniti possono essere archiviati e riutilizzati dai provider per riaddestrare i modelli futuri, rendendo tali informazioni potenzialmente accessibili all’esterno.
I collaboratori, alla ricerca di efficienza rapida per compiti specifici (come trascrivere riunioni, riassumere PDF o generare presentazioni), installano spesso plugin per il browser, bot su piattaforme di messaggistica interna o micro-servizi AI di terze parti senza il consenso del reparto IT.
Questi strumenti intermediari possono fungere da collettori invisibili di credenziali, conversazioni riservate e file aziendali, eludendo i sistemi centralizzati di Data Loss Prevention (DLP).
I Large Language Model (LLM) non sono motori di ricerca e non elaborano concetti secondo logica deduttiva: funzionano su base probabilistica, predicendo la sequenza di parole statisticamente più coerente con il contesto fornito. Questa caratteristica genera un falso senso di sicurezza nell’operatore.
I modelli generativi formulano le risposte con un tono autorevole, fluido e persuasivo anche quando affermano falsità integrali. Citazioni bibliografiche inventate, articoli di legge inesistenti o calcoli matematici errati (le cosiddette allucinazioni) vengono presentati con la stessa sicurezza di un dato verificato. Considerare l’output dell’AI come una fonte primaria è una delle cause principali di danni reputazionali verso clienti e stakeholder.
Gli sviluppatori sfruttano sempre più l’AI per accelerare la scrittura di script, funzioni e componenti software. Tuttavia, i modelli tendono a suggerire librerie deprecate, configurazioni permissive o pattern vulnerabili a injection e falle note. Un fenomeno emergente è inoltre la cosiddetta package hallucination: il modello inventa il nome di una libreria inesistente; gli attaccanti registrano pacchetti malevoli con quel nome esatto nei repository pubblici (come npm o PyPI) e il software aziendale finisce per scaricarli automaticamente.
Affidarsi a prompt sintetici e privi di contesto («Scrivimi un report sulle vendite del trimestre» oppure «Correggi questo testo per renderlo professionale») costringe il modello a riempire i vuoti informativi facendo supposizioni. Il risultato è quasi sempre un testo generico, ricco di cliché stilistici e privo della profondità analitica richiesta in ambito professionale.
L’adozione dell’AI in azienda non è solo una questione operativa, ma tocca la conformità contrattuale, le normative sui dati personali (GDPR) e i quadri normativi emergenti come l’AI Act europeo.
Lasciare al singolo dipendente la libertà di interpretare cosa sia lecito e cosa no crea una frammentazione pericolosa. In molte realtà manca ancora un documento operativo che chiarisca quali categorie di dati possano essere elaborate tramite AI, quali tool siano approvati, chi sia il responsabile finale dei deliverable e come debbano essere gestiti gli account di accesso.
L’intersezione tra intelligenza artificiale e diritto d’autore è un terreno complesso. Inserire materiale protetto da copyright nei prompt può costituire violazione delle licenze d’uso originali. Al contempo, in molte giurisdizioni le creazioni realizzate interamente da un’AI senza un apporto creativo umano dimostrabile non beneficiano della tutela del diritto d’autore, esponendo l’azienda all’impossibilità di difendere i propri asset digitali dalla copia concorrenziale.
Consegnare elaborati, perizie, codici sorgente, testi o analisi prodotti con l’ausilio dell’AI senza dichiararlo apertamente può violare accordi di non divulgazione (NDA), standard contrattuali o doveri deontologici. Quando un committente scopre autonomamente che una consulenza è stata delegata a una macchina senza alcuna disclosure preventiva, la fiducia commerciale subisce un danno difficilmente riparabile.
Gli ultimi due errori riguardano il rapporto tra autonomia decisionale della macchina e responsabilità del professionista.
Utilizzare l’output dell’AI per prendere decisioni che impattano direttamente sulle persone (ad esempio lo screening dei curricula per le assunzioni, la valutazione delle prestazioni, il merito creditizio o la prioritizzazione dei ticket di assistenza) senza un vaglio umano consapevole espone l’azienda a rischi sistemici di discriminazione e bias algoritmici. L’AI Act europeo classifica molte di queste applicazioni come sistemi “ad alto rischio”, imponendo obblighi stringenti di trasparenza e tracciabilità.
Considerare i sistemi di intelligenza artificiale come software tradizionali, deterministici e infallibili, è il presupposto che alimenta tutti gli errori precedenti. Se i professionisti non conoscono le nozioni base di funzionamento degli algoritmi probabilistici, i meccanismi di deriva semantica, la perdita di contesto nelle conversazioni lunghe e le tecniche di social engineering mirate all’AI (come il prompt injection), non potranno mai usarli in modo sicuro.
Evitare questi dieci errori non significa frenare l’adozione dell’intelligenza artificiale, ma trasformarla da esperimento frammentato e rischioso a vantaggio competitivo strutturato.
L’approccio più efficace consiste nell’istituire un modello a tre livelli:
L’AI rimane uno straordinario amplificatore di capacità: la responsabilità dell’accuratezza, della riservatezza e dell’etica del lavoro resta interamente in capo a chi la guida.
Articoli correlati
L’integrazione dell’intelligenza artificiale nei processi produttivi genera spesso il timore di una progressiva sostituzione dell’essere umano. Tuttavia, i dati delineano uno scenario diverso: circa un
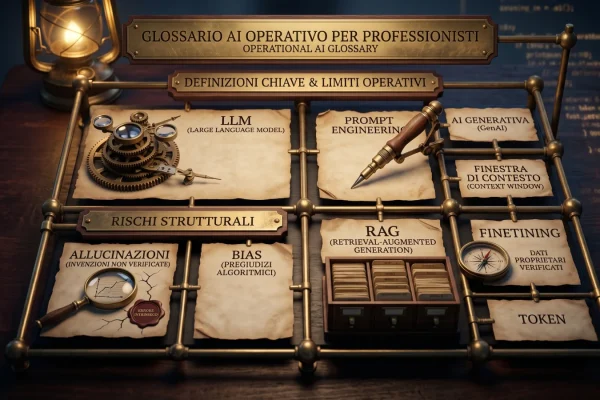
Sempre più spesso, durante le riunioni strategiche o di aggiornamento aziendale, emergono sigle come LLM, RAG o prompt. Non si tratta più di un linguaggio
Aprire ChatGPT per farsi aiutare a scrivere una mail complessa, riassumere un lungo report o correggere una porzione di codice è diventata un’abitudine quotidiana per
Il rischio di estinzione da intelligenza artificiale è tornato al centro del discorso pubblico. Questa volta con una firma precisa: il 9 settembre un ricercatore
Il Regolamento europeo sull’Intelligenza Artificiale, noto come AI Act, rappresenta il primo quadro normativo organico dell’Unione europea pensato per disciplinare lo sviluppo e l’impiego delle
Sapere quando interrompere un’iniziativa di intelligenza artificiale è uno dei test più severi per la governance aziendale. Nella narrazione dominante sull’innovazione tecnologica, l’abbandono di un’iniziativa