Sempre più spesso, durante le riunioni strategiche o di aggiornamento aziendale, emergono sigle come LLM, RAG o prompt. Non si tratta più di un linguaggio tecnico riservato esclusivamente ai dipartimenti IT, ma di termini che oggi influenzano direttamente le decisioni e l’organizzazione del management.
Questo glossario traduce i concetti tecnici dell’Intelligenza Artificiale Generativa in definizioni operative. L’obiettivo è fornire ai professionisti gli elementi essenziali per comprendere le reali capacità degli strumenti sul mercato, valutarne i limiti e prendere decisioni informate sulle possibili implementazioni.
È un sottoinsieme dell’intelligenza artificiale in grado di produrre nuovi contenuti (testo, immagini, codice) partendo da istruzioni umane. A differenza dell’AI tradizionale che analizza o classifica dati preesistenti, l’AI generativa crea output originali basandosi sui pattern appresi in fase di addestramento.
Il Modello Linguistico di Grandi Dimensioni è il motore algoritmico che alimenta piattaforme come ChatGPT o Claude. Il suo funzionamento si basa sulla probabilità statistica: prevede quale parola abbia più senso inserire dopo la precedente all’interno di un dato contesto.
Il prompt è l’istruzione in linguaggio naturale fornita all’AI. Il Prompt Engineering è la pratica di strutturare questa richiesta per limitare l’interpretazione autonoma della macchina e ottenere un risultato preciso.
I token sono i frammenti di parole che l’AI utilizza per elaborare il testo. La finestra di contesto è la “memoria a breve termine” del modello durante una singola sessione di lavoro, ed è misurata proprio in token.
Si verificano quando un LLM genera affermazioni false o inventate, presentandole all’utente con un tono estremamente sicuro e convincente.
I modelli assorbono i pregiudizi storici e culturali presenti nei dati umani su cui sono stati addestrati. Se utilizzato senza correttivi in contesti come la selezione del personale (HR), un modello potrebbe favorire specifiche categorie di candidati basandosi su pattern discriminatori del passato.
I modelli standard possiedono una vasta conoscenza generale, ma non hanno accesso ai dati privati di un’azienda (policy, listini, storico clienti). Per colmare questa lacuna si usano due approcci distinti.
È l’architettura più utilizzata in ambito aziendale per collegare un LLM ai dati proprietari in modo sicuro. Quando un utente fa una domanda, il sistema cerca prima l’informazione nei documenti interni dell’azienda, dopodiché chiede all’AI di formulare una risposta basandosi esclusivamente su quel testo recuperato.
Consiste nell’addestrare ulteriormente un modello fornendogli migliaia di esempi specifici per alterarne permanentemente il comportamento. Si utilizza non tanto per fornire nuove nozioni, quanto per insegnare all’AI a replicare uno specifico stile linguistico, un gergo molto tecnico o un formato rigoroso.
Articoli correlati
L’integrazione dell’intelligenza artificiale nei processi produttivi genera spesso il timore di una progressiva sostituzione dell’essere umano. Tuttavia, i dati delineano uno scenario diverso: circa un
Aprire ChatGPT per farsi aiutare a scrivere una mail complessa, riassumere un lungo report o correggere una porzione di codice è diventata un’abitudine quotidiana per
Il rischio di estinzione da intelligenza artificiale è tornato al centro del discorso pubblico. Questa volta con una firma precisa: il 9 settembre un ricercatore
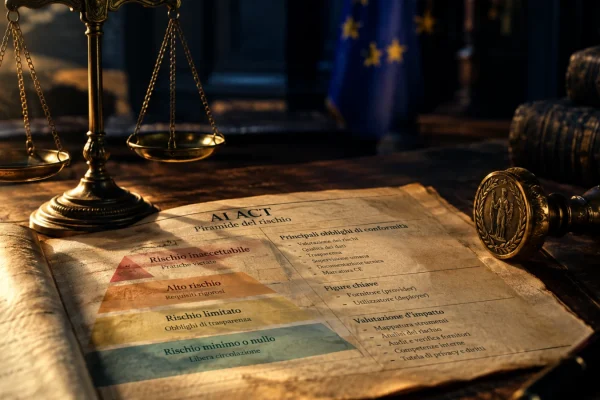
Il Regolamento europeo sull’Intelligenza Artificiale, noto come AI Act, rappresenta il primo quadro normativo organico dell’Unione europea pensato per disciplinare lo sviluppo e l’impiego delle
Sapere quando interrompere un’iniziativa di intelligenza artificiale è uno dei test più severi per la governance aziendale. Nella narrazione dominante sull’innovazione tecnologica, l’abbandono di un’iniziativa
Affidare l’intero ciclo di un progetto a un’unica conversazione con un modello linguistico può essere comodo, ma non sempre è il modo più controllabile di