Ogni volta che incolli un testo nella finestra di un modello di intelligenza artificiale generativa e premi invio, stai compiendo un atto giuridico: stai trasferendo informazioni a un soggetto terzo. Se quel testo contiene nomi, dettagli operativi di clienti, indirizzi email o estratti di cartelle cliniche, la comodità operativa si scontra istantaneamente con il Regolamento Generale sulla Protezione dei Dati (GDPR).
La regola di partenza è netta: i modelli di AI non sono blocchi per appunti privati né motori di ricerca anonimi. Qualsiasi informazione immessa viene registrata, processata su server spesso collocati fuori dall’Unione Europea e, nelle configurazioni standard, utilizzata per riaddestrare i sistemi. Comprendere dove finisce l’uso lecito e dove scatta la violazione normativa è l’unico modo per integrare questi strumenti nel lavoro quotidiano senza esporre persone fisiche e aziende a sanzioni pesanti.
Ai sensi dell’articolo 4 del GDPR, qualsiasi operazione applicata a dati personali — dalla semplice raccolta alla consultazione, fino alla conservazione o alla comunicazione — costituisce un trattamento. Inserire il riassunto di una riunione o la bozza di un contratto all’interno di un’interfaccia AI rientra a pieno titolo in questa definizione.
I rischi principali legati a questo flusso sono due:
Quando mancano accordi formali con il fornitore del servizio, l’immissione di dati personali equivale a una diffusione non autorizzata.
Esistono dati la cui immissione nei prompt di strumenti generalisti non ammette eccezioni, sia per la gravità del danno potenziale sia per la rigidità delle sanzioni previste dal quadro europeo.
L’articolo 9 del GDPR vieta il trattamento delle categorie particolari di dati, salvo specifiche deroghe difficilmente applicabili all’uso di assistenti virtuali standard. Rientrano in questo divieto assoluto:
A queste si aggiungono i dati giudiziari (articolo 10 del GDPR): informazioni su procedimenti penali, condanne, reati o carichi pendenti non possono in nessun caso essere fornite a sistemi di intelligenza artificiale privi di autorizzazioni specifiche e infrastrutture dedicate.
Non si tratta soltanto di evitare nomi e cognomi. Il GDPR tutela qualsiasi dato che consenta di risalire all’identità di una persona fisica, anche incrociando elementi diversi. Non vanno quindi inseriti:
I fogli di calcolo contenenti buste paga, i verbali di contestazione disciplinare, gli elenchi presenze o le liste lead non contrattualizzate per tale scopo contengono una concentrazione elevata di dati personali. Anche se l’obiettivo è soltanto formattare una tabella o estrarre una formula, caricare questi file espone l’azienda alla violazione del principio di integrità e riservatezza (articolo 5, paragrafo 1, lettera f).
Uno degli equivoci più diffusi consiste nel sostituire i nomi reali con nomi di fantasia (ad esempio “Mario Rossi” che diventa “Soggetto A”), ritenendo che questa operazione basti ad aggirare il GDPR.
Questa procedura è una pseudonimizzazione: riduce il rischio, ma il dato rimane personale ai sensi del Considerando 26 del regolamento, poiché chi possiede la chiave di decifrazione può comunque ricondurre il testo all’interessato. Se il contesto dell’operazione, la cronologia o i dettagli secondari permettono di risalire alla persona, il dato resta pienamente soggetto alla normativa.
L’anonimizzazione, al contrario, è un processo irreversibile che recide in modo definitivo ogni legame tra l’informazione e la persona fisica. Un testo è realmente anonimo quando nessun soggetto, nemmeno l’autore del prompt con l’ausilio di dati esterni, è in grado di identificare chi ne sia l’oggetto.
Le condizioni legali cambiano in modo sostanziale a seconda del contratto in essere con il fornitore dell’AI. Le versioni consumer gratuite (e molte versioni a pagamento per singoli utenti) operano tramite contratti standard in cui l’utente accetta che i dati forniti siano trattati per scopi propri del fornitore, incluso l’addestramento dei modelli. In questo scenario, caricare dati personali altrui è quasi sempre illecito.
Nelle versioni Enterprise, Business o tramite l’accesso via API dedicato alle organizzazioni, il modello contrattuale cambia:
Anche in presenza di un piano Enterprise e di un DPA firmato, rimane vietato caricare dati senza una base giuridica a monte. L’accordo contrattuale protegge l’infrastruttura, ma non sana l’assenza di trasparenza verso gli interessati.
Adottare un approccio a norma non significa rinunciare ai vantaggi dell’automazione, ma sviluppare abitudini di scrittura e verifica rigorose prima di premere invio.
La tecnologia generativa risponde all’input che riceve: la responsabilità della tutela della privacy ricade per intero su chi siede davanti alla tastiera.
Articoli correlati
L’integrazione dell’intelligenza artificiale nei processi produttivi genera spesso il timore di una progressiva sostituzione dell’essere umano. Tuttavia, i dati delineano uno scenario diverso: circa un
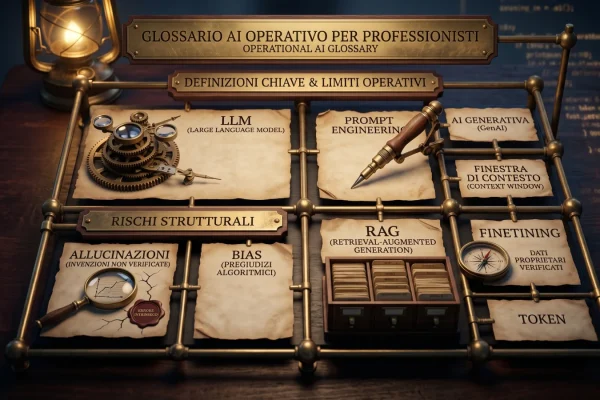
Sempre più spesso, durante le riunioni strategiche o di aggiornamento aziendale, emergono sigle come LLM, RAG o prompt. Non si tratta più di un linguaggio
Aprire ChatGPT per farsi aiutare a scrivere una mail complessa, riassumere un lungo report o correggere una porzione di codice è diventata un’abitudine quotidiana per
Il rischio di estinzione da intelligenza artificiale è tornato al centro del discorso pubblico. Questa volta con una firma precisa: il 9 settembre un ricercatore
Il Regolamento europeo sull’Intelligenza Artificiale, noto come AI Act, rappresenta il primo quadro normativo organico dell’Unione europea pensato per disciplinare lo sviluppo e l’impiego delle
Sapere quando interrompere un’iniziativa di intelligenza artificiale è uno dei test più severi per la governance aziendale. Nella narrazione dominante sull’innovazione tecnologica, l’abbandono di un’iniziativa